Me llamo Johannes Eva y creo sitios web desde hace 27 años. Baremo IA nació para cubrir una carencia: ninguna clasificación medía lo que me interesaba, la calidad de escritura de los modelos de IA en español.
Los benchmarks públicos se centran en el código, las matemáticas y el razonamiento. La pequeña parte que dedican a la escritura casi siempre se evalúa en inglés. Aquí solo importa la calidad de los textos generados. Las consignas se conciben directamente en español y las respuestas se comparan a ciegas.
Los modelos que pueden ejecutarse en casa ocupan un lugar especial. Gemma 4, Qwen 3.6 y 3.8, Ling 3.0 Flash, Muse Glimmer y Granite 4.2 son algunas de las familias marcadas con 🏠. Se han ejecutado localmente con varias cuantizaciones, con el razonamiento activado y desactivado.
Este sitio es un proyecto personal. Ningún proveedor de modelos me paga y no tengo ningún interés en favorecer a uno.
Los equipos utilizados para los modelos locales
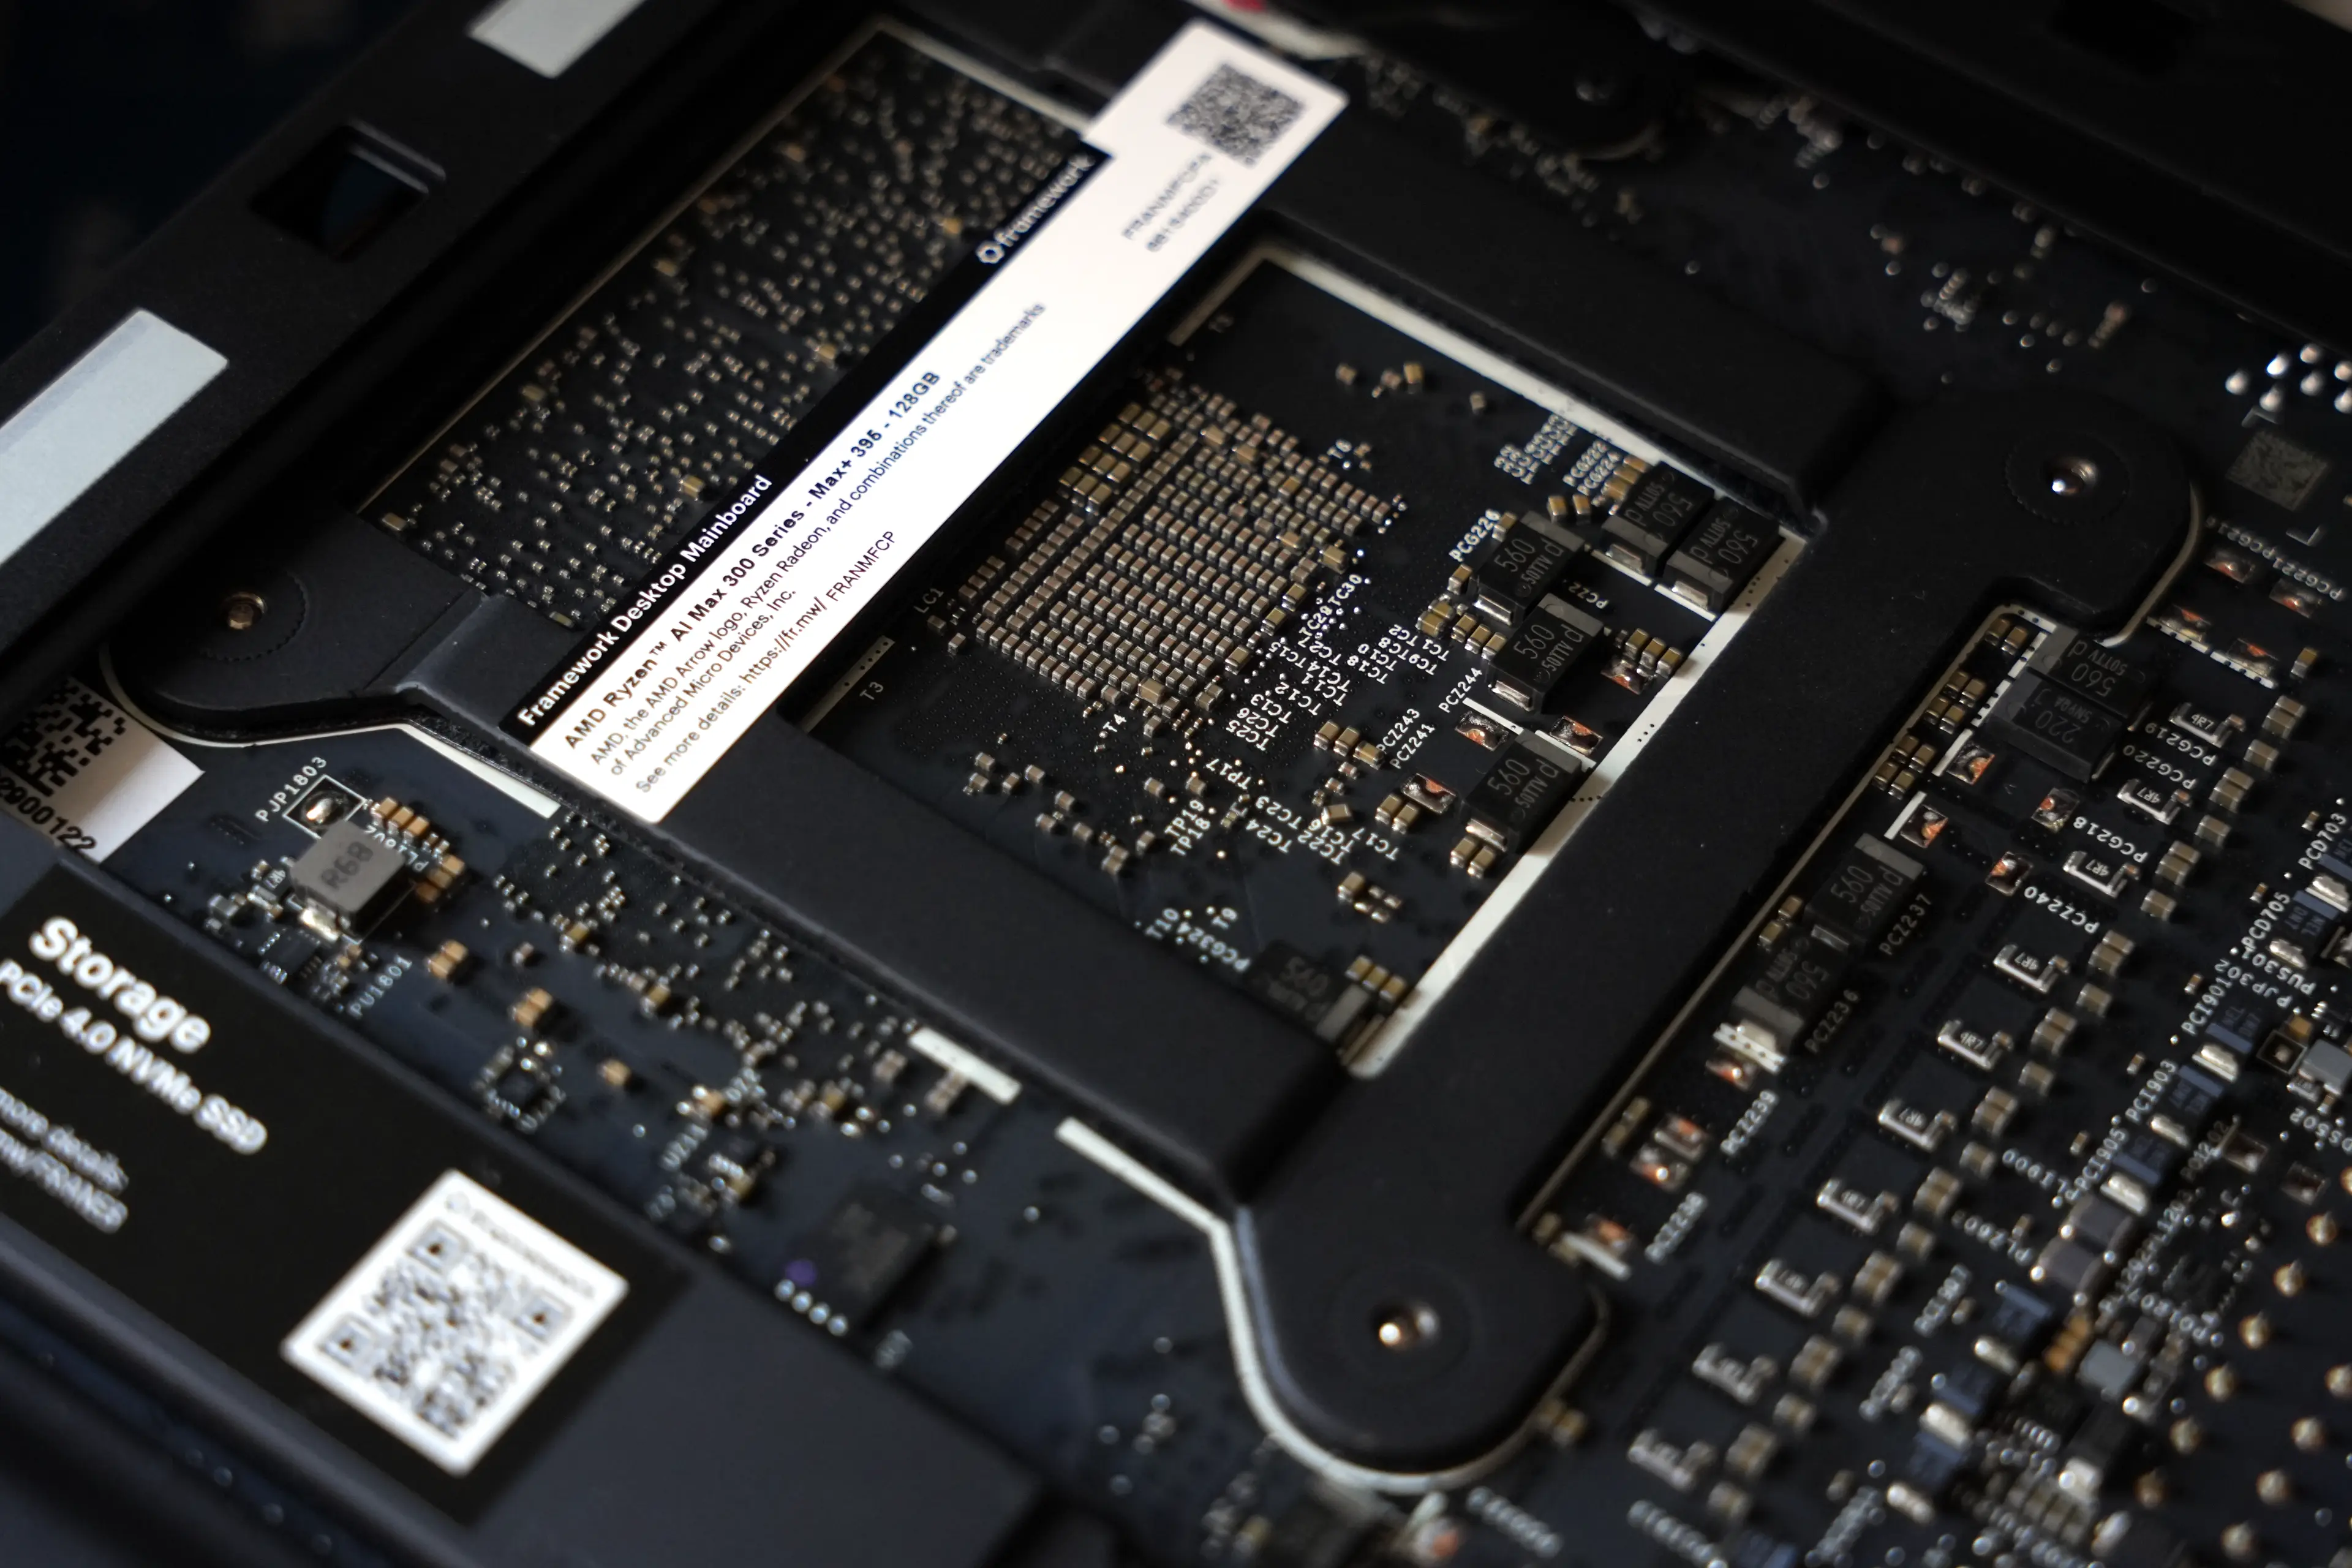
- Ordenador
- Framework Desktop, AMD Ryzen AI Max serie 300, revisión A6
- Procesador
- AMD Ryzen AI Max+ 395, 16 núcleos y 32 hilos, hasta 5,19 GHz
- Gráficos
- AMD Radeon 8060S integrada
- Memoria
- 128 GB de memoria unificada, compartida por el procesador y la unidad gráfica
Los modelos locales se ejecutan en un Framework Desktop con un AMD Ryzen AI Max+ 395. Sus 128 GB de memoria unificada están disponibles tanto para el procesador como para la unidad gráfica, lo que permite cargar modelos más grandes que en la mayoría de las tarjetas gráficas de consumo. Un segundo equipo con una NVIDIA GeForce RTX 5070 Ti aporta los modelos más ligeros.
Velocidad de generación local observada (Strix Halo)
Mediana de tokens generados por segundo en la máquina Strix Halo (Framework Desktop, Ryzen AI Max+ 395), calculada a partir de las respuestas válidas del benchmark generadas en ella e incluidos los tokens de razonamiento. La velocidad varía según la longitud del contexto y el programa utilizado. Los modelos sin suficientes mediciones en Strix Halo no aparecen en la lista.
| Modelo | Cuantización | Velocidad mediana | Respuestas |
|---|---|---|---|
| Gemma 4 26B A4B | Q8_0 | 39.8 tokens/s | 465 |
| Gemma 4 E2B | Q4_K_M | 39.4 tokens/s | 224 |
| Gemma 4 E4B | Q8_0 | 35.9 tokens/s | 542 |
| Gemma 4 E2B | Q6_K | 33.2 tokens/s | 216 |
| Ling 3.0 Flash | Q4_K_M | 31.6 tokens/s | 277 |
| Ling 3.0 Flash | Q4_K_M | 30.5 tokens/s | 240 |
| Gemma 4 E2B | Q8_0 | 29.2 tokens/s | 224 |
| Gemma 4 26B A4B QAT | QAT-Q4_0 | 27.9 tokens/s | 118 |
| Qwen3.6 35B A3B | Q4_K_M | 26.6 tokens/s | 347 |
| Nemotron 3 Nano Omni | Q4_K_M | 25.1 tokens/s | 960 |
| Gemma 4 E4B | Q4_K_M | 22.4 tokens/s | 221 |
| Qwen3.6 35B A3B | Q8_0 | 22.1 tokens/s | 312 |
| Nemotron 3 Nano Omni | Q8_0 | 21.2 tokens/s | 391 |
| Nemotron 3 Super | Q4_K_M | 21.1 tokens/s | 413 |
| Gemma 4 26B A4B | Q6_K | 20.2 tokens/s | 539 |
| Gemma 4 E4B | Q6_K | 18.6 tokens/s | 218 |
| Granite 4.2 8B | Q4_K_M | 16.9 tokens/s | 36 |
| Gemma 4 12B | Q8_0 | 14.6 tokens/s | 124 |
| Gemma 4 12B QAT | QAT-Q4_0 | 11 tokens/s | 752 |
| Gemma 4 31B QAT | QAT-Q4_0 | 10 tokens/s | 548 |
| Gemma 4 12B | Q6_K | 9 tokens/s | 216 |
| Qwen3.8 27B | Q4_K_M | 8.9 tokens/s | 546 |
| Muse Glimmer 30B Kquant 17gb | K-Quant 17GB | 8.8 tokens/s | 394 |
| Qwen3.8 27B | Q8_0 | 8.4 tokens/s | 498 |
| Muse Glimmer 30B Kquant Dynamic | K-Quant Dynamic | 8 tokens/s | 397 |
| Granite 4.2 30B | Q4_K_M | 7.6 tokens/s | 423 |
| Qwen3.6 27B | Q8_0 | 7.5 tokens/s | 190 |
| Qwen3.8 27B | Q6_K | 7 tokens/s | 504 |
| Granite 4.2 30B | Q6_K | 6.6 tokens/s | 397 |
| Gemma 4 31B | Q6_K | 5.8 tokens/s | 527 |
| Qwen3.6 27B | Q4_K_M | 5.2 tokens/s | 588 |
| Granite 4.2 30B | Q8_0 | 4.9 tokens/s | 447 |
| Gemma 4 31B | Q8_0 | 4.8 tokens/s | 316 |