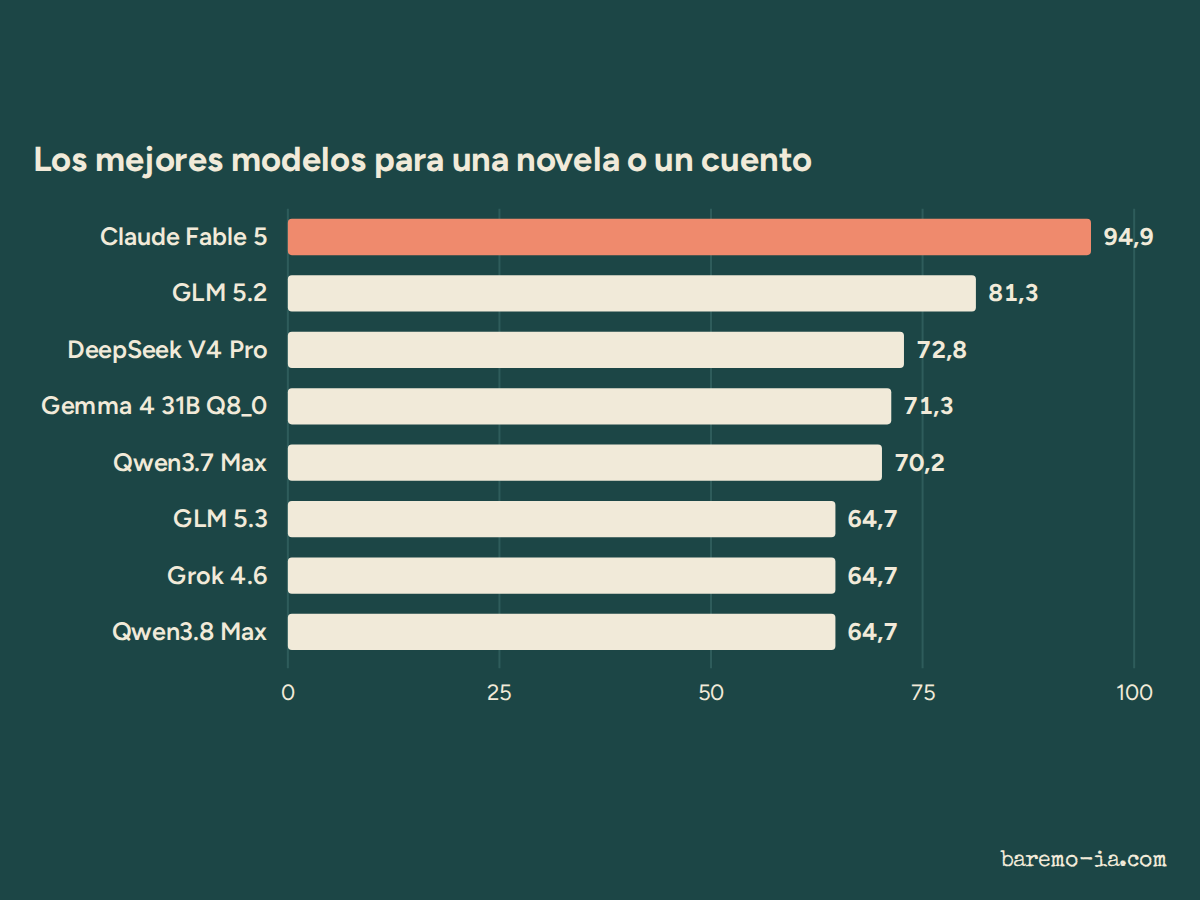
Los modelos se ordenan por la calidad de sus textos en español. Usa los filtros para acotar la lista. Para las categorías de escritura seleccionadas, los puestos se calculan antes de aplicar los filtros de proveedor, tamaño, acceso, razonamiento y cuantización; por eso los modelos ocultos pueden dejar huecos.
Última actualización:
Clasificación de modelos de escritura basada en resultados por pares
Puesto
Modelo
Puntuación
del juez IA
Puntuación
humana
1
Claude Opus 5.5 💡 adaptive high
97,6
—
2
Claude Opus 5 💡 adaptive high
97,4
—
3
Claude Fable 5.1 💡 adaptive high
97,0
—
4
Kimi K3 💡 enabled
95,6
—
5
GPT-6.1 Sol 💡 high
95,0
—
6
Claude Fable 5 💡 adaptive high
94,6
—
7
GPT-6 Astra 💡 high
94,3
—
7
Kimi K3.1 Pro 💡 high
94,3
—
9
Claude Fable 5.2 💡 adaptive high
94,2
—
11
GLM 5.3 💡 max
92,1
—
12
Claude Sonnet 5.5 💡 adaptive high
91,9
—
13
GPT-6 Sol 💡 high
91,8
—
14
Qwen4 Max 💡 high
91,0
—
15
Muse Spark 1.2 💡 high
90,4
—
16
Grok 4.7 💡 high
89,1
—
17
GPT-6.1 Terra 💡 high
87,2
—
18
DeepSeek V4.1 Flash 💡 high
86,5
—
19
Muse Spark 1.3 💡 high
85,7
—
20
Gemini 4 Argon 💡 high
84,4
—
21
GPT-5.6 Sol 💡 high
83,6
—
22
GPT-6 Luna 💡 high
83,4
—
23
Gemini 3.8 Flash 💡 high
83,1
—
23
Ling 3.1 Flash 💡 high
83,1
—
25
Claude Sonnet 5 💡 adaptive high
82,8
—
26
Aion 3.5 💡 high
82,1
—
28
Qwen3.8 Max 💡 xhigh
81,7
—
29
GPT-5.6 Terra 💡 high
81,2
—
30
Gemini 4 Hydrogen 💡 high
80,1
—
31
Claude Haiku 5.5 💡 adaptive high
78,9
—
32
MiMo V2.6 Pro fp8 💡 high
75,8
—
33
GPT-5.6 Luna 💡 high
75,1
—
34
MiniMax M3 💡 enabled
74,5
—
35
Qwen3.7 Max 💡 enabled
72,5
—
36
DeepSeek V4 Pro 💡 enabled
72,0
—
37
Step 5 Preview fp8 💡 high
71,7
—
38
Inkling 💡 high
69,6
—
39
Grok 4.6 💡 high
69,1
—
40
Ling 3.2 Flash 💡 high
67,3
—
41
Qwen3.8 Flash 💡 high
66,0
—
42
GLM 5.2 💡 enabled
65,4
—
43
Beam 1.0 💡 high
64,7
—
44
Qwen3.8 27B Q8_0 💡 xhigh** 🏠
62,5
—
45
Qwen3.7 Plus 💡 enabled
61,0
—
46
Mistral Large 4 💡 high
60,0
—
47
Gemma 4 31B Q8_0 💡 on* 🏠
59,9
—
48
Hy4 Preview 💡 high
59,7
—
51
Gemini 3.7 Flash 💡 medium
56,9
—
52
DeepSeek V4 Flash 💡 enabled
56,8
—
53
Gemma 4 31B Q8_0 ↯ 🏠
55,5
—
53
Muse Ember 💡 high
55,5
—
57
Gemma 4 26B A4B Q8_0 ↯ 🏠
53,8
—
58
Mercury 3 💡 high
52,9
—
61
Nemotron 3.5 Super VL 💡 high
50,4
—
62
Seed 2.1 Turbo ↯
50,2
—
66
Gemma 4 26B A4B Q8_0 💡 on* 🏠
48,0
—
67
Aion 3.0 💡 mandatory
43,9
—
68
Gemma 4 12B Q8_0 💡 on* 🏠
43,5
—
69
GLM 5.3 Flash 💡 high
43,4
—
71
Nemotron 3 Ultra 💡 high
41,8
—
72
Hy3 💡 high
41,5
—
74
MiMo V2.6 Flash 💡 high
40,3
—
74
Qwen3.6 27B Q8_0 💡 on* 🏠
40,3
—
78
MiMo V2.5 Pro 💡 enabled
38,2
—
80
Gemma 4 12B Q8_0 ↯ 🏠
37,3
—
81
Qwen3.6 35B A3B Q8_0 💡 on* 🏠
36,8
—
86
Qwen3.8 27B Q8_0 ↯ 🏠
30,7
—
90
Agnes 3.0 Flash 💡 high
24,5
—
92
Mistral Medium 3.5 💡 high
20,9
—
94
Nemotron 3.5 Lightning 💡 high
16,1
—
96
Qwen3.6 35B A3B Q8_0 ↯ 🏠
15,9
—
97
Gemma 4 E4B Q8_0 💡 on* 🏠
13,4
—
98
Gemma 4 E2B Q8_0 💡 on* 🏠
13,1
—
101
MiMo V2.5 💡 enabled
12,3
—
102
Qwen3.6 27B Q8_0 ↯ 🏠
11,9
—
103
Gemma 4 E2B Q8_0 ↯ 🏠
11,0
—
109
Gemma 4 E4B Q8_0 ↯ 🏠
9,3
—
110
Flint V1.0 💡 high
9,1
—
116
Granite 4.2 30B Q8_0 💡 full 🏠
6,8
—
117
Nemotron 3 Nano Omni 30B A3B Q8_0 💡 on* 🏠
6,2
—
120
Granite 4.2 8B Q8_0 💡 full 🏠
1,8
—
121
MiniMax M3.1 Flash 💡 high
1,5
—
Todavía no hay resultados publicados para esta selección
Un modelo aparece tras su primera evaluación individual publicada; su puntuación de clasificación aparece tras su primer duelo admisible.
121 modelos comparados · 126.604 veredictos de IA publicados
Método: modelo de Bradley–Terry regularizado. La puntuación del juez IA determina el puesto; la puntuación humana es independiente y sigue siendo secundaria hasta que haya más votos de la comunidad. Una puntuación de 50 equivale a una probabilidad estimada de una entre dos de superar al modelo medio en este idioma y categoría.
Resultados de los duelos directos
Cada celda muestra la proporción de puntos posibles que obtiene el modelo de la fila frente al modelo de la columna: una victoria vale el 100 %, un empate el 50 % y una derrota el 0 %. Esta matriz solo usa los protocolos de evaluación compatibles con la clasificación principal.
Matriz direccional de los puntos obtenidos en duelos directos. Por encima del 50 % favorece al modelo de la fila; por debajo, al de la columna.
0 %100 %
💡 indica un modelo con razonamiento, ↯ uno sin razonamiento. 🏠 indica un modelo ejecutado localmente en el ordenador del autor de este sitio.«on*» indica un razonamiento que solo se activa o se desactiva (modelos locales sin niveles intermedios): el nivel solicitado, high, no está disponible en el archivo local, que usa el modo activado por defecto. En los modelos locales con razonamiento ajustable (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash), el nivel mostrado (xhigh**, high, full) es el nivel por defecto del modelo: el nivel solicitado no está disponible en el archivo local, que usa su nivel por defecto.
Ver como tabla
Puntos obtenidos en duelos directos por pareja de modelos
Modelo
Cobertura de duelos publicados
Cada celda muestra cuántos duelos juzgados por IA y publicados, en todos los protocolos, comparan los dos modelos para este idioma y categoría. Los modelos de ambos ejes son candidatos; la matriz no indica qué juez emitió cada veredicto.
Matriz simétrica del número de duelos publicados. La diagonal es cero porque un modelo no se compara consigo mismo.
0
💡 indica un modelo con razonamiento, ↯ uno sin razonamiento. 🏠 indica un modelo ejecutado localmente en el ordenador del autor de este sitio.«on*» indica un razonamiento que solo se activa o se desactiva (modelos locales sin niveles intermedios): el nivel solicitado, high, no está disponible en el archivo local, que usa el modo activado por defecto. En los modelos locales con razonamiento ajustable (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash), el nivel mostrado (xhigh**, high, full) es el nivel por defecto del modelo: el nivel solicitado no está disponible en el archivo local, que usa su nivel por defecto.
Ver como tabla
Duelos publicados por pareja de modelos
Modelo
Ayuda a elegir el mejor modelo para escribir en español
¿Qué modelo escribe el mejor texto? Juzga esta pareja anónima y contribuye a la clasificación humana. Durante el duelo no verás qué modelo escribió cada texto. Los nombres se revelan al terminar.
La clasificación tiene un ganador; tus textos tienen varios. Solo con los duelos de un tipo de texto, a 20 de septiembre de 2026, Claude Fable 5 gana la ficción, Claude Opus 5 los correos personales, Claude Fable 5.1 las cartas de presentación y Kimi K3 las explicaciones. Una guía sencilla, tarea por tarea, con el mejor archivo para tu propio ordenador.
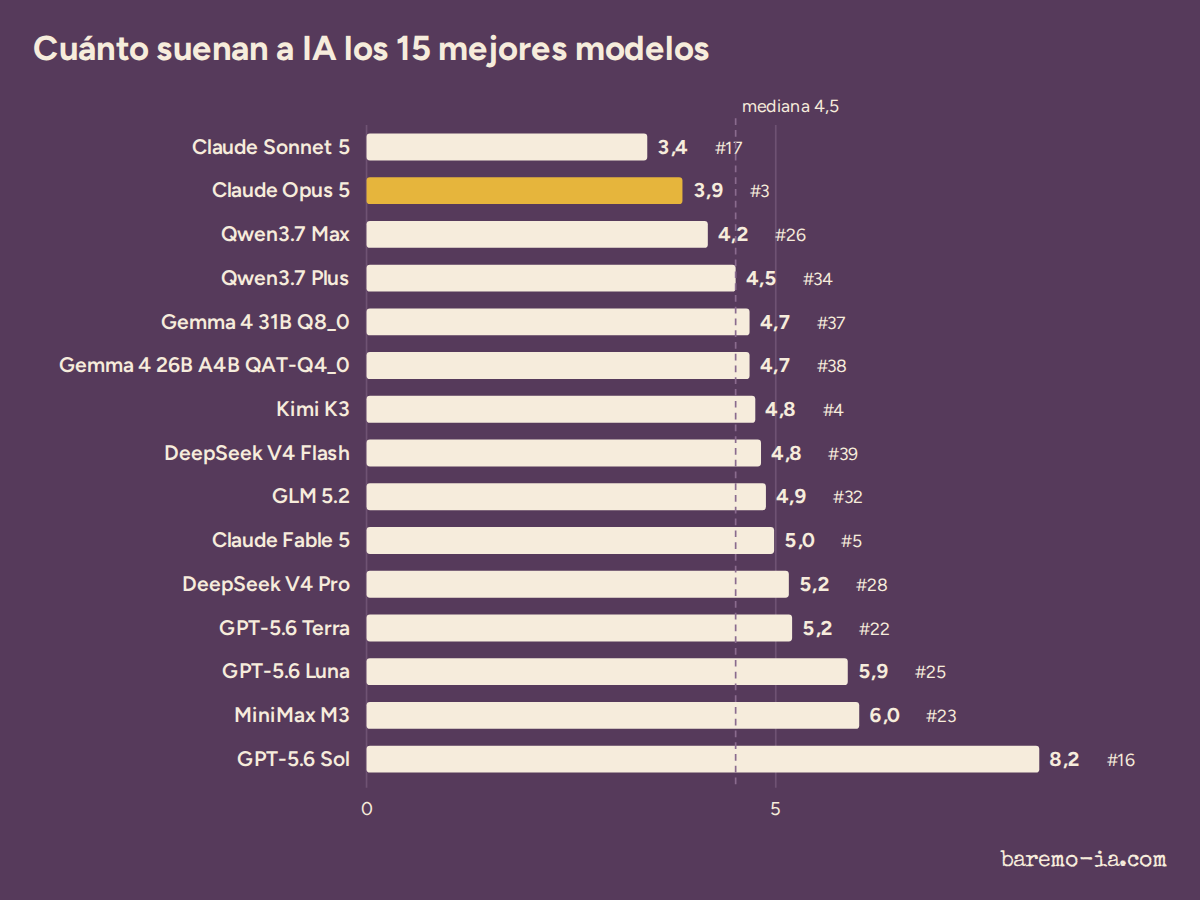
Contamos en 3 084 textos clasificados en español las marcas que los lectores llaman «de IA»: rayas, muletillas, «no X, sino Y», listas de tres, calcos del inglés. Claude Opus 5, segundo de la clasificación el 20 de septiembre de 2026, es también uno de los más sobrios; GPT-5.6 Sol, noveno, el que más marcas deja, con una lista de tres cada 280 palabras. Y «además» aparece 431 veces.
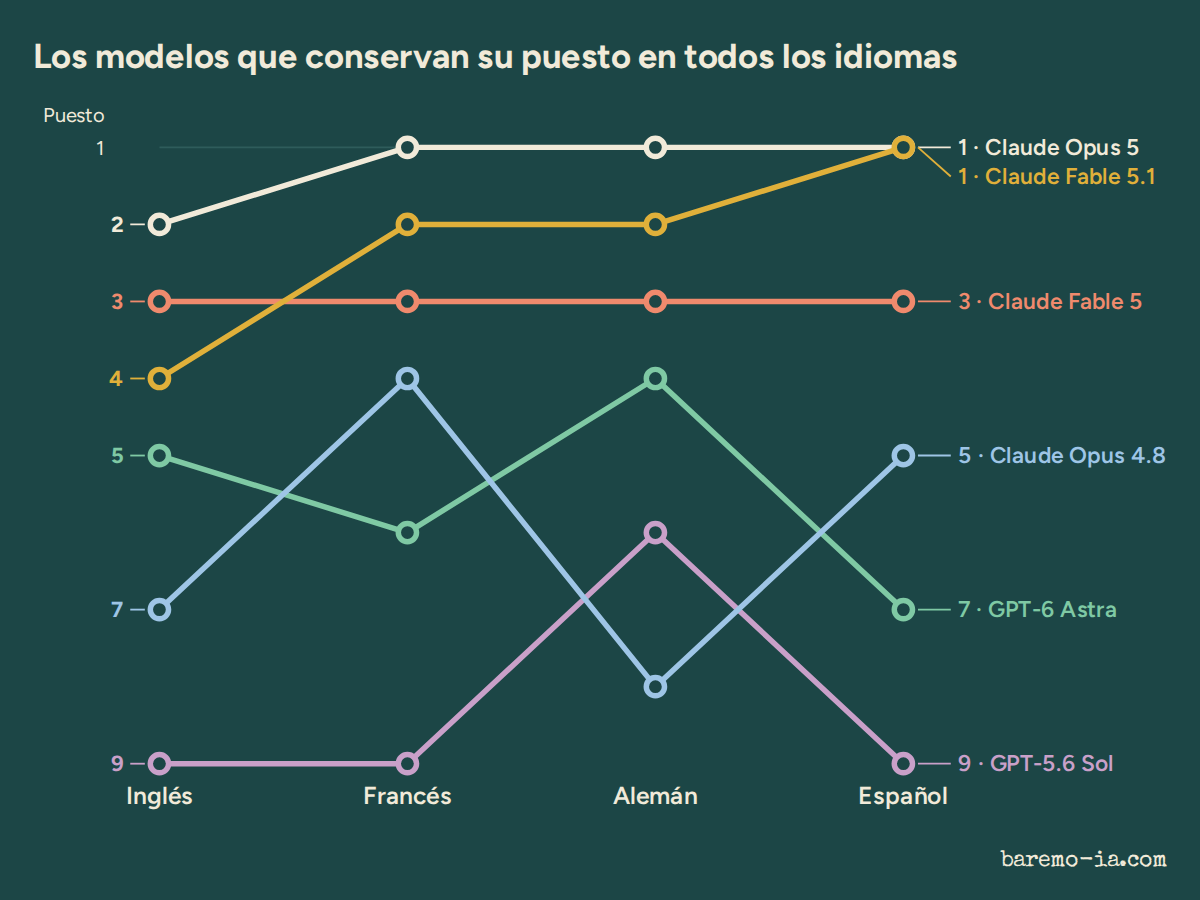
Noventa y un modelos están clasificados en inglés, francés, alemán y español con el mismo protocolo. A 20 de septiembre de 2026, Claude Fable 5 es tercero en los cuatro; Claude Fable 5.1, primero en español. Más abajo, Grok 4.6 es 21.º en español y 60.º en francés, GLM 5.3 Flash 10.º en inglés y 54.º en alemán, y el mejor modelo local cambia con cada idioma.
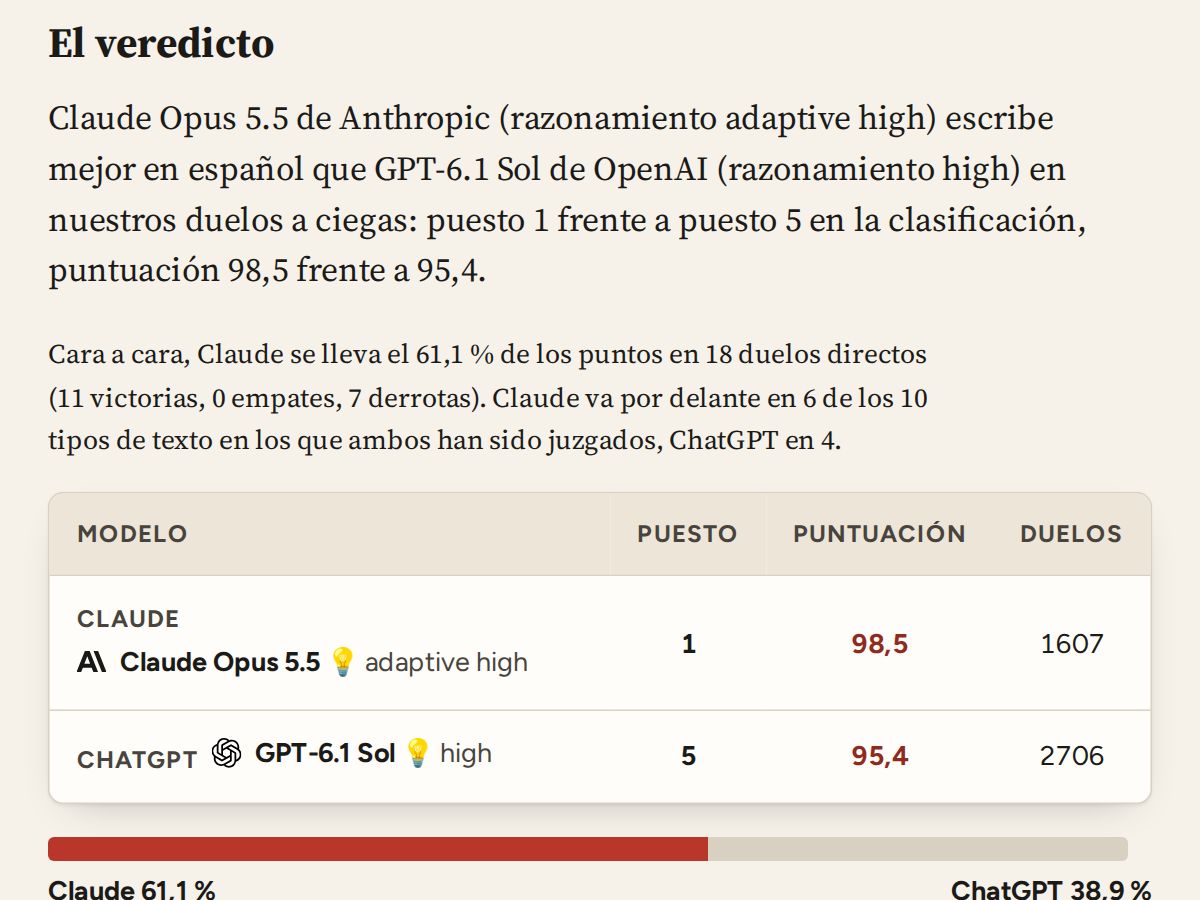
Los dos asistentes por los que más se pregunta, juzgados con las mismas consignas en español en duelos a ciegas: cuál escribe mejor, por cuánto y en qué tipos de texto. Se actualiza con cada exportación de la clasificación.
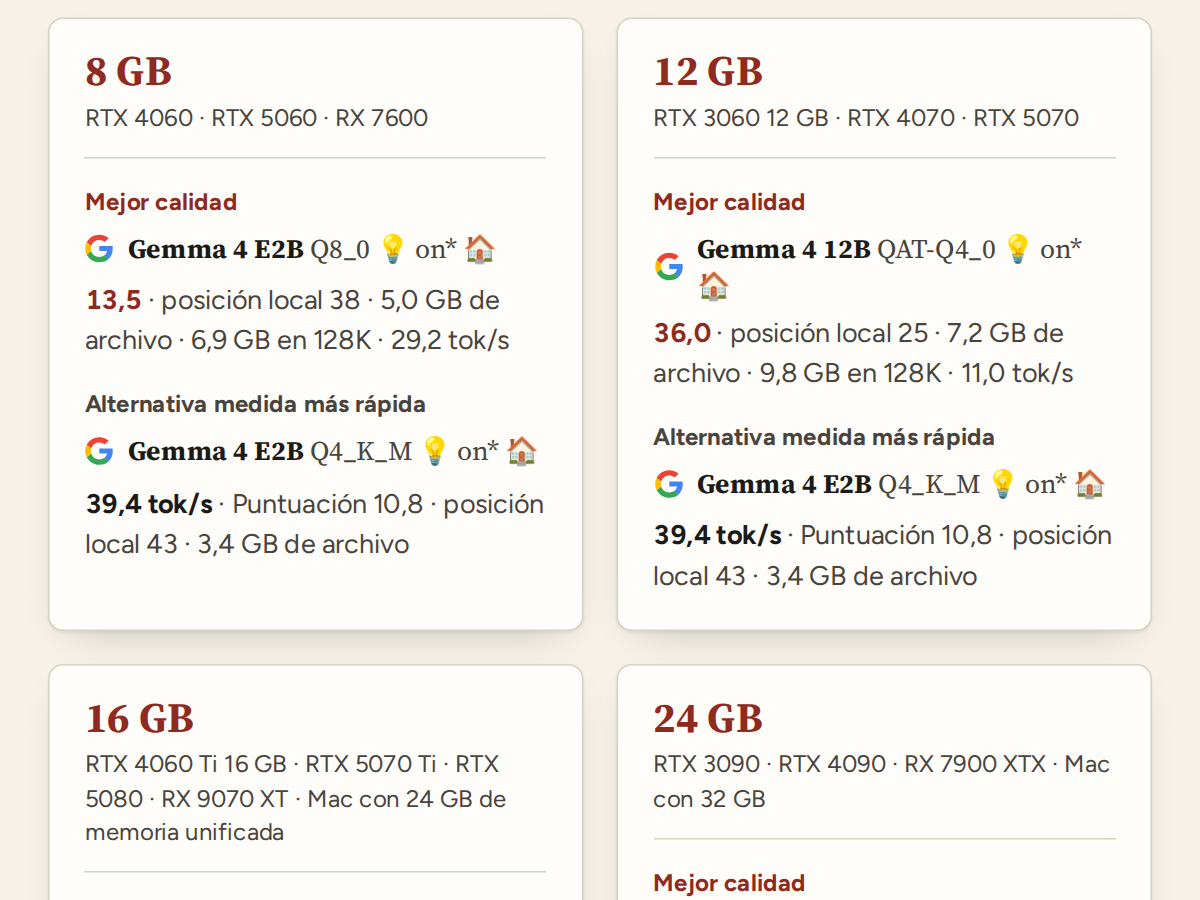
La clasificación viva de los modelos de pesos abiertos para escribir en español, la memoria que necesita cada archivo y lo que cabe en 16, 24, 32 o 128 GB.