Strix Halo es el nombre en clave de la serie Ryzen AI Max de AMD, el primer chip para PC con suficiente memoria unificada para cargar modelos que antes exigían un armario de tarjetas gráficas. Nuestra máquina es un Framework Desktop: 16 núcleos, una Radeon 8060S integrada y 128 GB de LPDDR5X compartidos entre procesador y gráficos. Es una configuración habitual, de algo más de 2 000 euros, y la pregunta sobre ella es siempre la misma: qué puede ejecutar y a qué velocidad.
Podemos responder con mediciones y no con estimaciones, porque el propio baremo generó miles de textos en ella. La tabla da, para cada archivo de modelo probado, la mediana de tokens por segundo sobre las respuestas válidas generadas en esta máquina, tokens de razonamiento incluidos, junto al tamaño del archivo, la memoria necesaria con un contexto de 128 000 tokens lleno y la puntuación de escritura del modelo en la clasificación de esta edición.
| Modelo | Tok/s mediana | Archivo (GB) | +128K (GB) | Parámetros | Puntuación | Respuestas |
|---|---|---|---|---|---|---|
 Gemma 4 26B A4B 💡 🏠 | 39,8 | 28,1 | 31,0 | 26,0 B (4,0 B activos) | 48,0 | 465 |
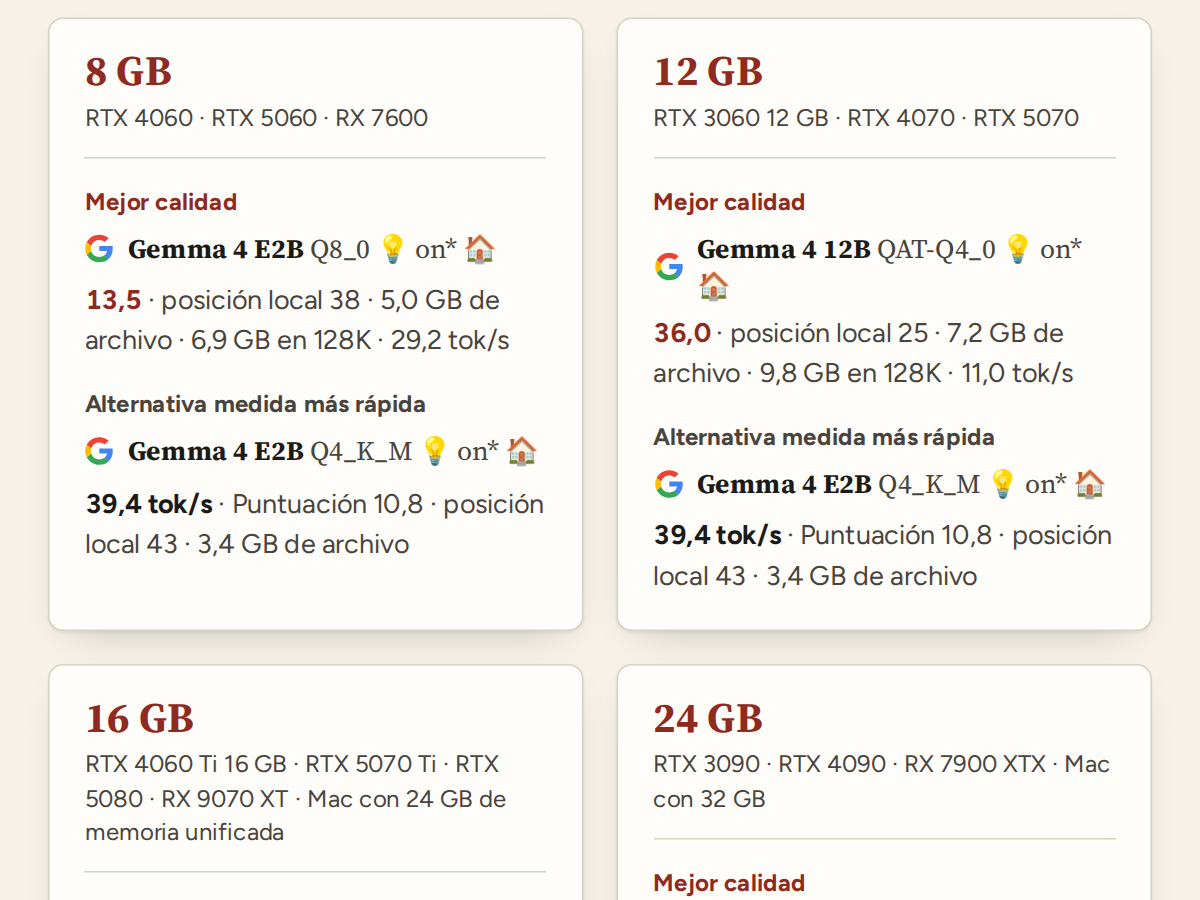
| Gemma 4 E2B 💡 🏠 | 39,4 | 3,4 | 5,3 | 5,1 B | 10,4 | 224 |
| Gemma 4 E4B 💡 🏠 | 35,9 | 8,0 | 11,9 | 8,0 B | 13,4 | 542 |
| Gemma 4 E2B 💡 🏠 | 33,2 | 3,9 | 5,8 | 5,1 B | 12,9 | 216 |
 Ling 3.0 Flash 💡 🏠 | 31,6 | 77,0 | 78,2 | 124,0 B (5,1 B activos) | 20,5 | 277 |
| Ling 3.0 Flash ↯ 🏠 | 30,5 | 77,0 | 78,2 | 124,0 B (5,1 B activos) | 16,0 | 240 |
| Gemma 4 E2B 💡 🏠 | 29,2 | 5,0 | 6,9 | 5,1 B | 13,1 | 224 |
| Gemma 4 26B A4B 💡 🏠 | 27,9 | 15,6 | 18,6 | 26,0 B (4,0 B activos) | 55,3 | 118 |
 Qwen3.6 35B A3B 💡 🏠 | 26,6 | 22,1 | 24,8 | 35,0 B (3,0 B activos) | 42,1 | 347 |
 Nemotron 3 Nano Omni 30B A3B 💡 🏠 | 25,1 | 26,1 | 27,0 | 30,0 B (3,0 B activos) | 7,0 | 960 |
| Gemma 4 E4B 💡 🏠 | 22,4 | 6,3 | 10,2 | 8,0 B | 6,9 | 221 |
| Qwen3.6 35B A3B 💡 🏠 | 22,1 | 37,8 | 40,6 | 35,0 B (3,0 B activos) | 36,8 | 312 |
| Nemotron 3 Nano Omni 30B A3B 💡 🏠 | 21,2 | 35,2 | 36,1 | 30,0 B (3,0 B activos) | 6,2 | 391 |
| Nemotron 3 Super 120B A12B 💡 🏠 | 21,1 | 86,1 | 87,5 | 120,0 B (12,0 B activos) | 21,5 | 413 |
| Gemma 4 26B A4B 💡 🏠 | 20,2 | 23,8 | 26,8 | 26,0 B (4,0 B activos) | 49,1 | 539 |
| Gemma 4 E4B 💡 🏠 | 18,6 | 6,2 | 10,1 | 8,0 B | 10,0 | 218 |
 Granite 4.2 8B 💡 🏠 | 16,9 | 5,3 | 26,8 | 8,0 B | 5,0 | 36 |
| Gemma 4 12B 💡 🏠 | 14,6 | 12,7 | 15,3 | 12,0 B | 43,5 | 124 |
| Gemma 4 12B 💡 🏠 | 11,0 | 7,2 | 9,8 | 12,0 B | 35,3 | 752 |
| Gemma 4 31B 💡 🏠 | 10,0 | 17,7 | 29,6 | 31,0 B | 49,9 | 548 |
| Gemma 4 12B 💡 🏠 | 9,0 | 9,8 | 12,4 | 12,0 B | 37,8 | 216 |
| Qwen3.8 27B 💡 🏠 | 8,9 | 17,7 | 26,5 | 27,0 B | 39,4 | 546 |
 Muse Glimmer 30B 💡 🏠 | 8,8 | 18,2 | 20,0 | 29,6 B | 57,8 | 394 |
| Qwen3.8 27B 💡 🏠 | 8,4 | 30,0 | 38,7 | 27,0 B | 62,5 | 498 |
| Muse Glimmer 30B 💡 🏠 | 8,0 | 21,1 | 22,9 | 29,6 B | 48,1 | 397 |
| Granite 4.2 30B 💡 🏠 | 7,6 | 17,7 | 52,1 | 30,0 B | 6,1 | 423 |
| Qwen3.6 27B 💡 🏠 | 7,5 | 28,6 | 37,3 | 27,0 B | 40,3 | 190 |
| Qwen3.8 27B 💡 🏠 | 7,0 | 23,4 | 32,1 | 27,0 B | 52,8 | 504 |
| Granite 4.2 30B 💡 🏠 | 6,6 | 24,0 | 58,4 | 30,0 B | 8,6 | 397 |
| Gemma 4 31B 💡 🏠 | 5,8 | 26,4 | 38,4 | 31,0 B | 57,2 | 527 |
| Qwen3.6 27B 💡 🏠 | 5,2 | 16,5 | 25,3 | 27,0 B | 38,3 | 588 |
| Granite 4.2 30B 💡 🏠 | 4,9 | 31,1 | 65,5 | 30,0 B | 6,8 | 447 |
| Gemma 4 31B 💡 🏠 | 4,8 | 33,8 | 45,8 | 31,0 B | 59,9 | 316 |
Ninguna medición coincide con estos filtros.
Mediana de tokens por segundo sobre las respuestas válidas del baremo generadas en esta máquina, tokens de razonamiento incluidos; la cifra abarca el procesamiento del prompt y la generación, que se miden por separado; archivo y memoria como en la página IA local; puntuación de la clasificación principal de esta edición. Véase también: mediciones publicadas por la comunidad para el Ryzen AI Max+ 395.
La regla general: ancho de banda, no cómputo
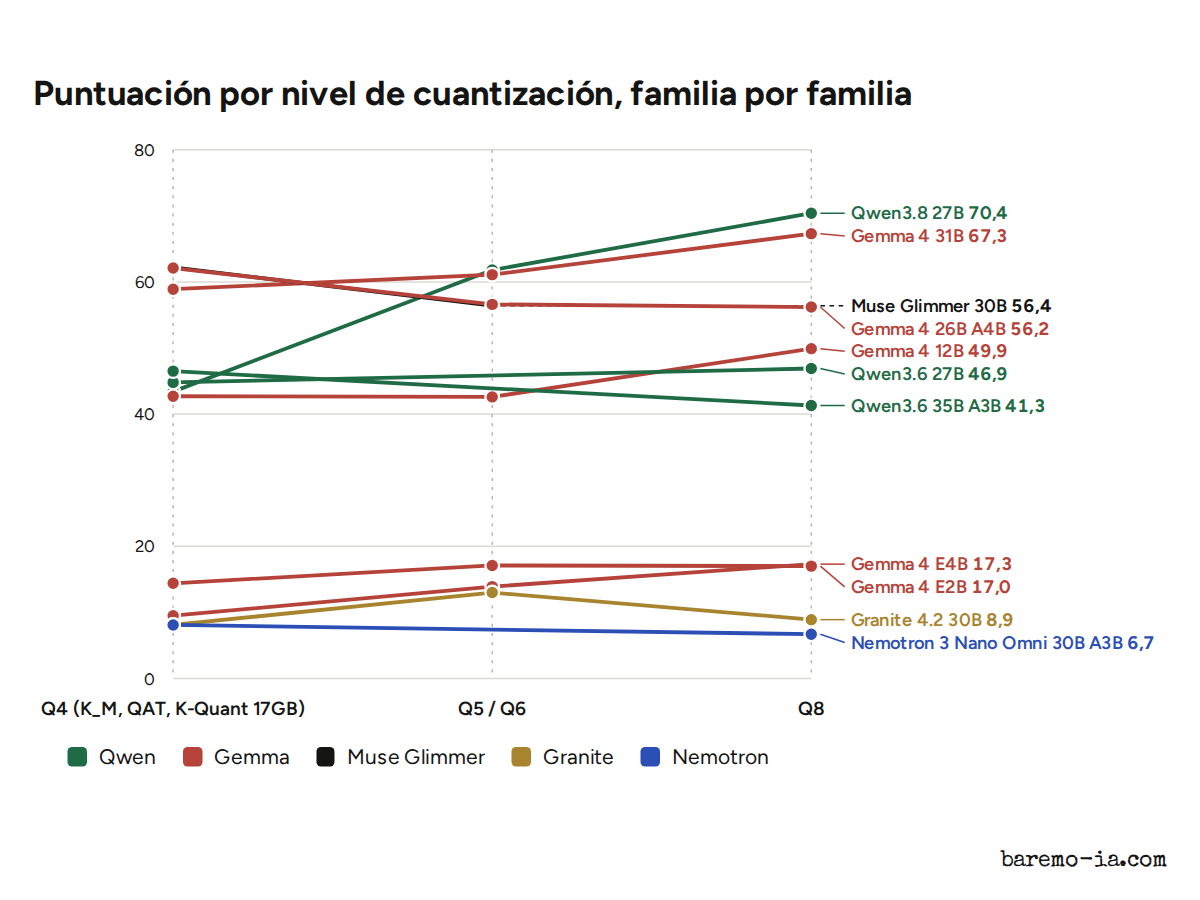
Cuando un modelo genera texto, cada token exige leer una vez todos los pesos activos. En Strix Halo la memoria entrega unos 256 GB por segundo, así que un modelo denso guardado en 30 GB (Qwen3.8 27B en Q8_0) no puede superar unos 8,5 tokens por segundo, y medimos 8,4. Gemma 4 31B Q8_0, de 34 GB, se queda en 4,8. Reducir el archivo a la mitad con una cuantización Q4 duplica aproximadamente la velocidad, al coste documentado en nuestro análisis de cuantizaciones.
Los modelos de mezcla de expertos escapan a la regla: guardan muchos parámetros pero activan pocos por token. Gemma 4 26B A4B lee 4 000 millones de parámetros por token y alcanza 40 tokens por segundo en Q8_0; Qwen3.6 35B A3B llega a 22; Ling 3.0 Flash, un archivo de 77 GB, aún produce 30 tokens por segundo porque solo trabajan 5 000 millones de parámetros a la vez. En este hardware, el mejor compromiso para escribir es un modelo de expertos en Q8, no un modelo denso en Q4.
Lo que compran de verdad los 128 GB
Memoria, no velocidad. Nemotron 3 Super 120B en Q4_K_M es un archivo de 86 GB que ninguna tarjeta gráfica de consumo puede alojar; aquí corre a 21 tokens por segundo. Ling 3.0 Flash, de 77 GB, carga con margen para un contexto largo. Un modelo denso de 70 000 millones de parámetros en Q4 también cabe, pero a unos 5 tokens por segundo es una herramienta para escritores pacientes. Los benchmarks de la comunidad dan al M4 Max de Apple más o menos el doble de velocidad que Strix Halo en esos modelos densos de 70B, por entre 1 800 y 2 200 dólares más; en los modelos de expertos la diferencia es mucho menor.
Cómo se midieron las cifras
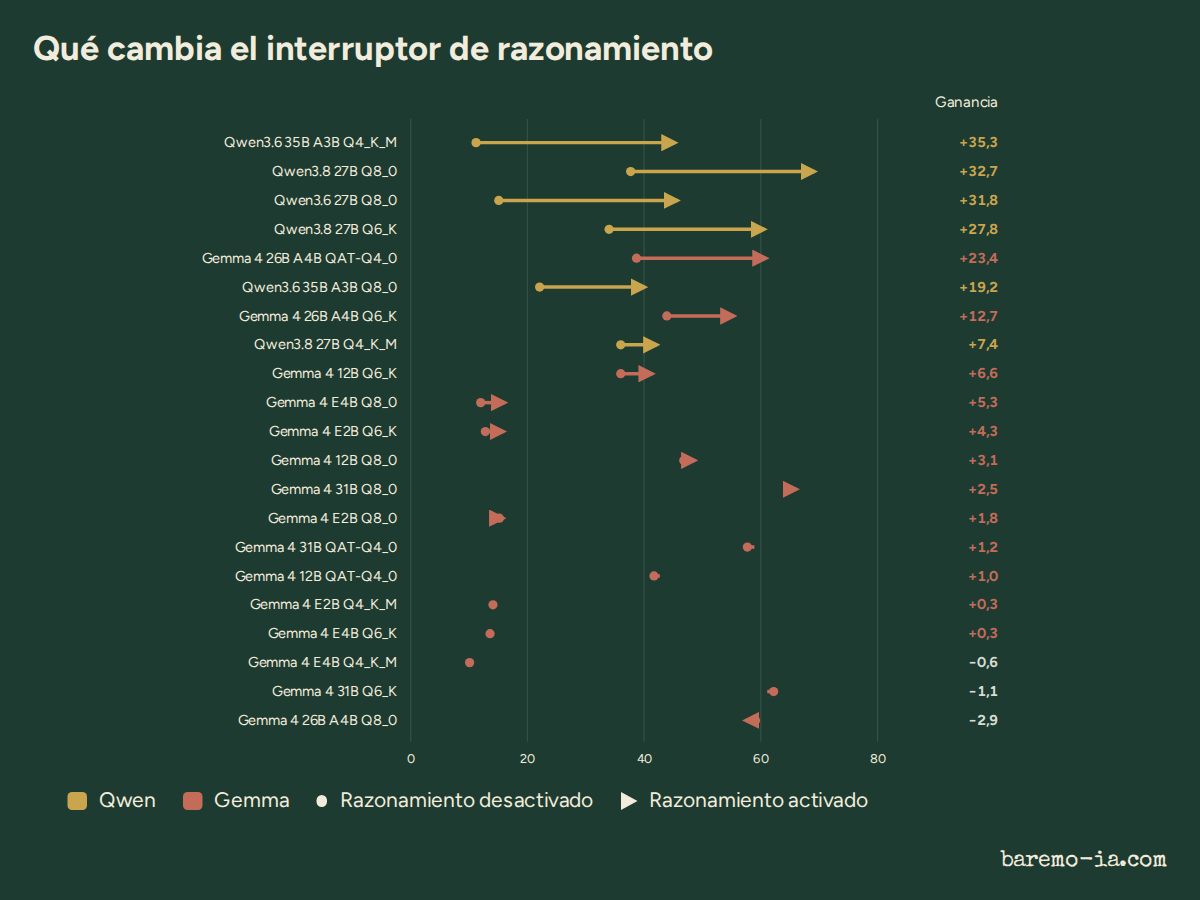
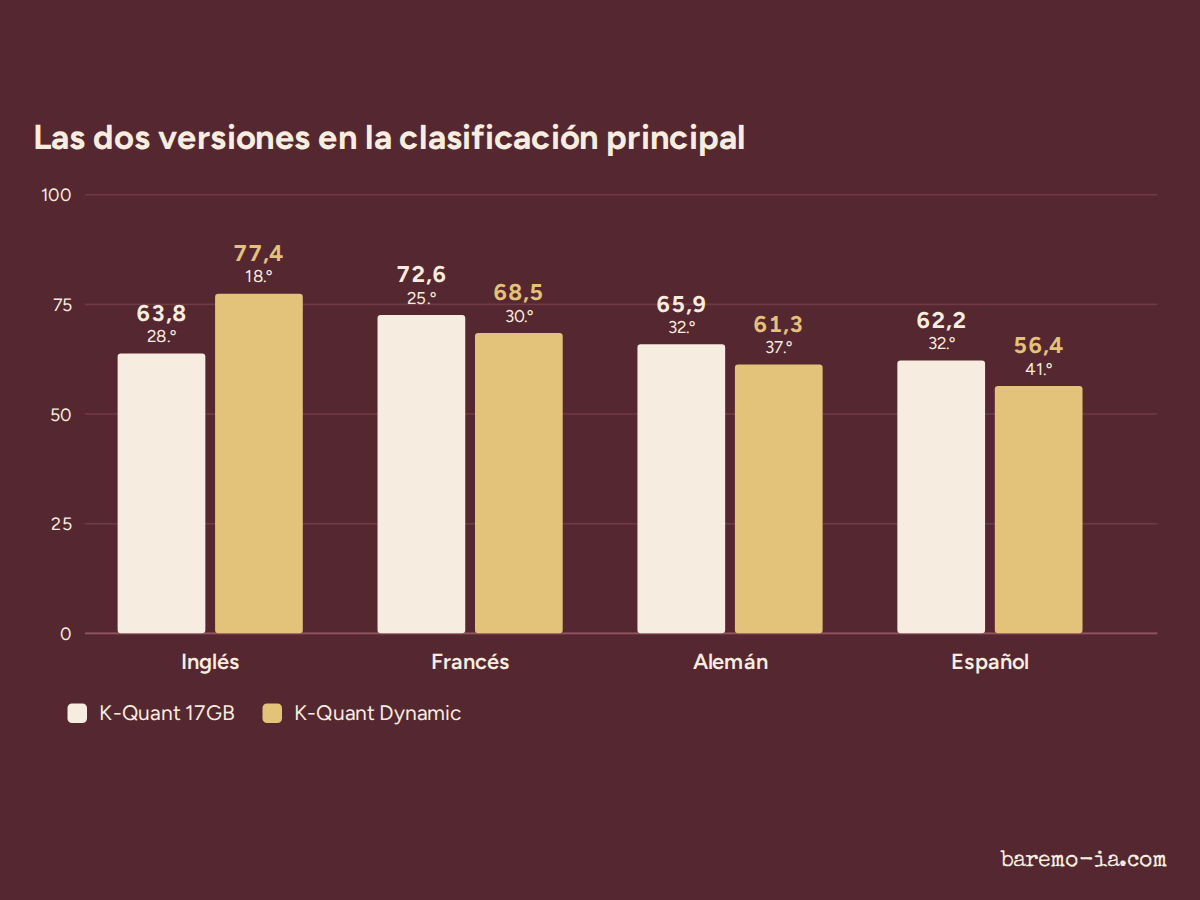
El motor llama.cpp de LM Studio, ajustes por defecto, las mismas 240 consignas por idioma que el resto del baremo, razonamiento activado cuando el modelo lo permite. La mediana se toma sobre respuestas completas, así que incluye la fase de razonamiento y el procesado de la consigna; una consigna corta con un razonamiento largo baja la cifra, que es justo lo que vive quien escribe. Las velocidades varían con la longitud del contexto, el backend (Vulkan o ROCm) y las versiones de los controladores: léelas como una ordenación de los modelos entre sí en una máquina, no como una promesa absoluta. La calidad procede de la clasificación de IA local, que usa los mismos archivos.
Fuentes y lecturas
- AMD Strix Halo backend benchmarks (llama.cpp en ROCm y Vulkan, muchos modelos)
- Comunidad Framework: pruebas de rendimiento LLM del Ryzen AI Max+ 395
- Level1Techs: resultados de benchmarks LLM en Strix Halo